
前四天都在補地基,今天終於開始讓專案真的動起來。
今天做兩件事:
uv 把專案骨架建起來中間還出現了一組很有意思的數字:
0.29s vs 11.78s
它直接讓我改掉原本的串流設計。
原因其實很單純:快,而且省事。
uv 會幫你管理 Python 版本、建立環境、安裝依賴,也能直接執行專案指令。
像這樣:
[project.scripts]
ironman = "ironman.cli:app"

[dependency-groups]
dev = [
    "pytest>=8.3",
    "pytest-asyncio>=0.24",
]
有了 project.scripts 之後,就可以直接:
uv run ironman
dependency-groups 則把測試工具獨立出來,不會跟正式依賴混在一起。
另外 uv sync 產生的 uv.lock 我也會一起放進版控,這樣之後換電腦或換環境,比較不容易出現「我這邊可以跑、你那邊不行」的情況。
今天先不碰 SDK,直接看最裸的樣子:
payload = {
    "model": config.MODEL_MAIN,
    "messages": [
        {"role": "user", "content": "用一句話說明什麼是 HTTP。"}
    ],
    "stream": False,
}

async with httpx.AsyncClient(timeout=config.REQUEST_TIMEOUT) as client:
    resp = await client.post(
        f"{config.OLLAMA_HOST}/api/chat",
        json=payload
    )
    data = resp.json()
其實就這樣而已。
一個 JSON 丟出去,再拿一個 JSON 回來。
這也是我刻意不先用官方套件的原因。先看過最原始的樣子,後面再包抽象層時,才會比較知道自己到底包了什麼。
接著我把這一層收進 llm.py,變成整個系列共用的 LLM 呼叫出口。之後不管是 Day 13 的 ReAct,還是 Day 22 的 Multi-Agent,最後都會走進同一個檔案。
一開始很容易以為:
為什麼模型第二輪還記得前面講過什麼?
答案其實很普通:
因為我們又把前面的對話一起送了一次。
LLM 本身沒有「長期記憶」,它只是根據這次收到的 messages 回答。
所以只要對話越長,送出去的資料也會越長。
這件事今天先知道就好,等到 Day 26 講 Session、Workspace、Memory 時,會再正式碰到。
我一開始做串流時,只接了 content。
結果畫面一直空白,差點以為程式卡住。
後來把原始回傳印出來才發現,nemotron-3.5-lightning 這種推理模型,前面先吐的是 thinking,不是 content。
所以我把原本的串流改成兩條軌道:
async def stream_events(...):
    async with self.client.stream("POST", "/api/chat", json=payload) as resp:
        async for line in resp.aiter_lines():
            chunk = json.loads(line)
            msg = chunk.get("message", {})

            if think := msg.get("thinking"):
                yield "thinking", think

            if piece := msg.get("content"):
                yield "content", piece
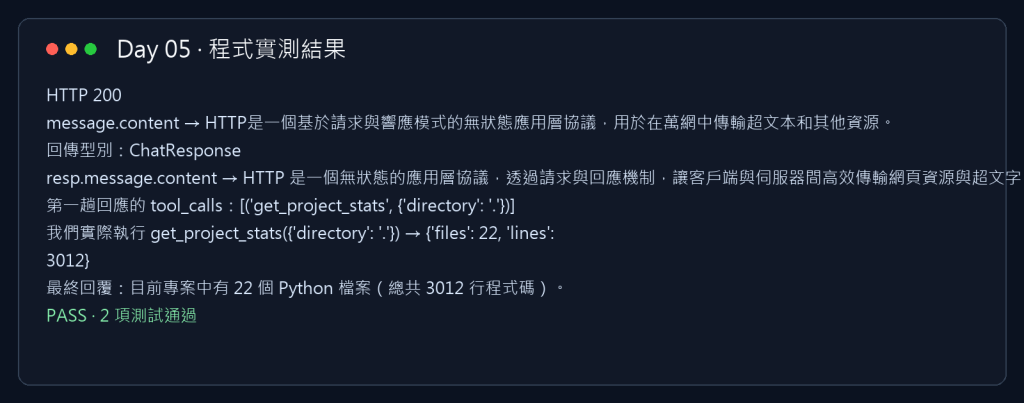
實測結果很有意思:
非串流:畫面空白 12.90s,然後答案一次全部出現

串流,而且把兩條軌道分開看:
  第一個 thinking token   0.29s
  第一個 content token   11.78s
  全部講完              12.79s
  思考 2466 字 → 答案 109 字
也就是說,模型其實在 0.29 秒就開始動了,只是它先在「想」,還沒正式「回答」。
如果 UI 只顯示 content,使用者會覺得整個程式像死掉一樣。
這也是今天最大的一個收穫:
串流不只是讓回答提早出現,也會影響你怎麼設計介面。
今天也順便跑了一次最基本的工具呼叫。
流程大概是這樣:
first = await llm.chat(messages, tools=[spec])
call = first.message.tool_calls[0]

result = get_project_stats(**call.arguments)

messages.append(first.message)
messages.append(
    ChatMessage(
        role="tool",
        tool_name=call.name,
        content=json.dumps(result)
    )
)

second = await llm.chat(messages, tools=[spec])
這裡最重要的一件事是:
模型不會自己去執行工具。
它只會先告訴你:
然後停下來等你。
你真的去執行工具,把結果包成 role="tool" 的訊息送回去,它才會繼續生成最終回答。
今天這個例子裡,第一趟只拿到:
get_project_stats({'directory': '.'})
我們自己執行後,得到:
{"files": 22, "lines": 3012}
再送回模型,它才整理成自然語言答案。
其實從這裡開始,後面 Agent 的骨架就已經出現了:
模型決定要呼叫什麼
        ↓
程式執行工具
        ↓
把結果送回模型
        ↓
模型繼續回答
今天終於讓專案真的從「地基」走到「會動」。
我自己覺得最重要的有三件事:
另外還有那組今天最關鍵的數字:
第一個 thinking token   0.29s
第一個 content token   11.78s
它直接提醒我:
如果只看 content,你可能會誤判模型根本沒在工作。
這個觀察後面做 ReAct、Agent 和 Multi-Agent 時,應該都還會再用到。
下一篇要回到一個更根本的問題:
MCP 到底是什麼?
現在 function calling 已經可以讓模型呼叫工具了,那為什麼還需要 MCP?
所以 Day 6 會先把 Host / Client / Server 這三個角色講清楚,後面再繼續往下做。


 iThome鐵人賽
 看影片追技術